1
Savoir ce qu’on a
Découverte avec et sans agent : réseau, virtualisation, cloud et Kubernetes, dans un métamodèle prêt à l’emploi.
Solutions · CMDB et Discovery
La CMDB de Keolux One tient l’inventaire et les dépendances de votre système d’information à jour à partir de vos sources : découverte avec et sans agent, réseau, virtualisation, cloud et Kubernetes. Vous décidez de ce qui entre grâce à une confiance réglée par source et une file de validation, et la CMDB se lit sans formation, du technicien au responsable d’application.
En bref
CMDB, découverte, ITSM et outils d’extension dans une seule plateforme, autour de cinq questions que se pose une DSI.
1
Découverte avec et sans agent : réseau, virtualisation, cloud et Kubernetes, dans un métamodèle prêt à l’emploi.
2
Explorateur des relations sur plusieurs niveaux, analyse d’impact en un clic, incidents et changements rattachés aux CI.
3
Confiance réglée par source, file de validation, règles de classification, détection des disparus et de la fin de support.
4
Connecteurs natifs, ETL Studio pour les autres sources, API GraphQL et REST, webhooks.
5
Droits par rôle, table et champ, journal d’audit de chaque modification, paquets de configuration versionnés.
2 000+
règles de classification livrées pour les équipements, systèmes, logiciels et services
600+
versions de systèmes suivies avec leur date de fin de support
14
sources de collecte prêtes à l’emploi, de l’annuaire au cloud
1 · Savoir ce qu’on a
Un serveur de collecte, KLX-SRV, s’installe dans votre réseau. Il n’ouvre aucun port entrant : il va chercher ses travaux auprès de la plateforme en HTTPS sortant. Plusieurs serveurs peuvent couvrir plusieurs sites.
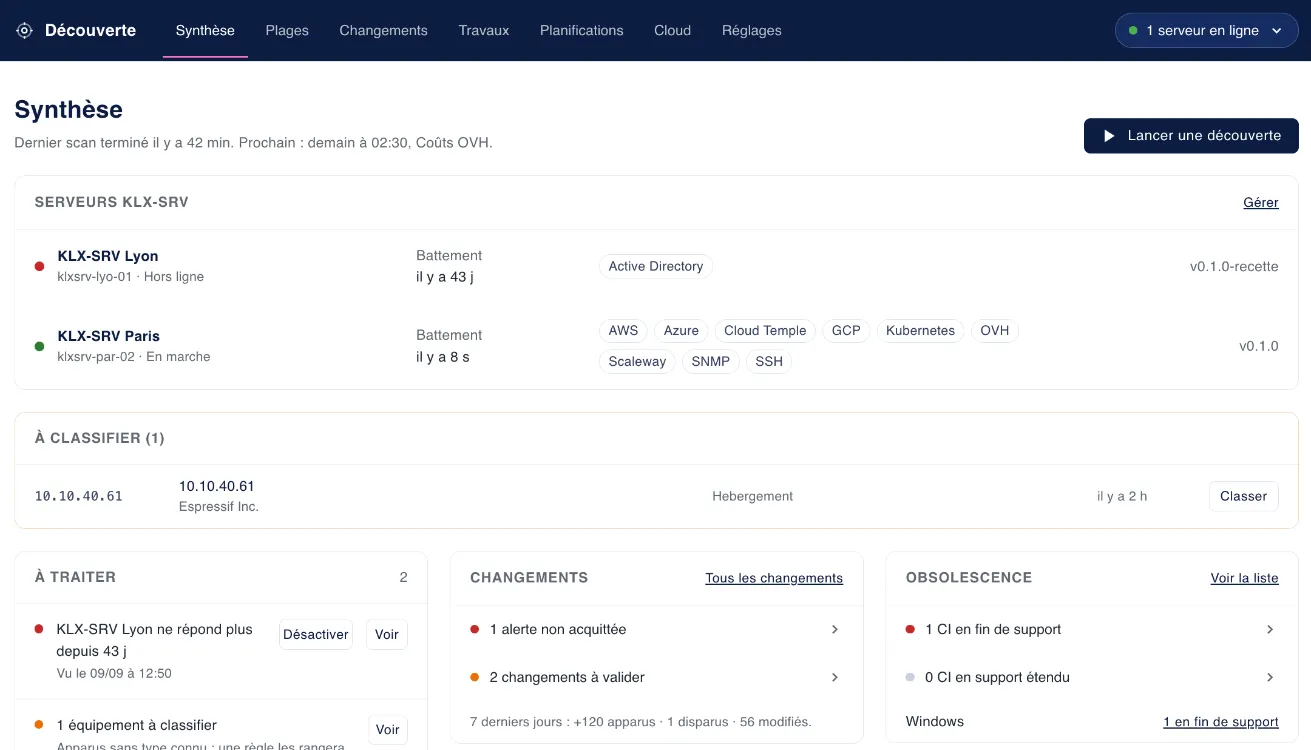
Les identifiants de collecte sont chiffrés dans le navigateur et ne sont conservés que sur le serveur de collecte.
2 · Savoir ce qui casse si ça tombe
Si cet hyperviseur s’arrête, quelles applications tombent ? L’explorateur remonte les relations sur 1 à 5 niveaux, impacts vers le haut et dépendances vers le bas, et n’affiche que le périmètre concerné. La vue se partage par son adresse.
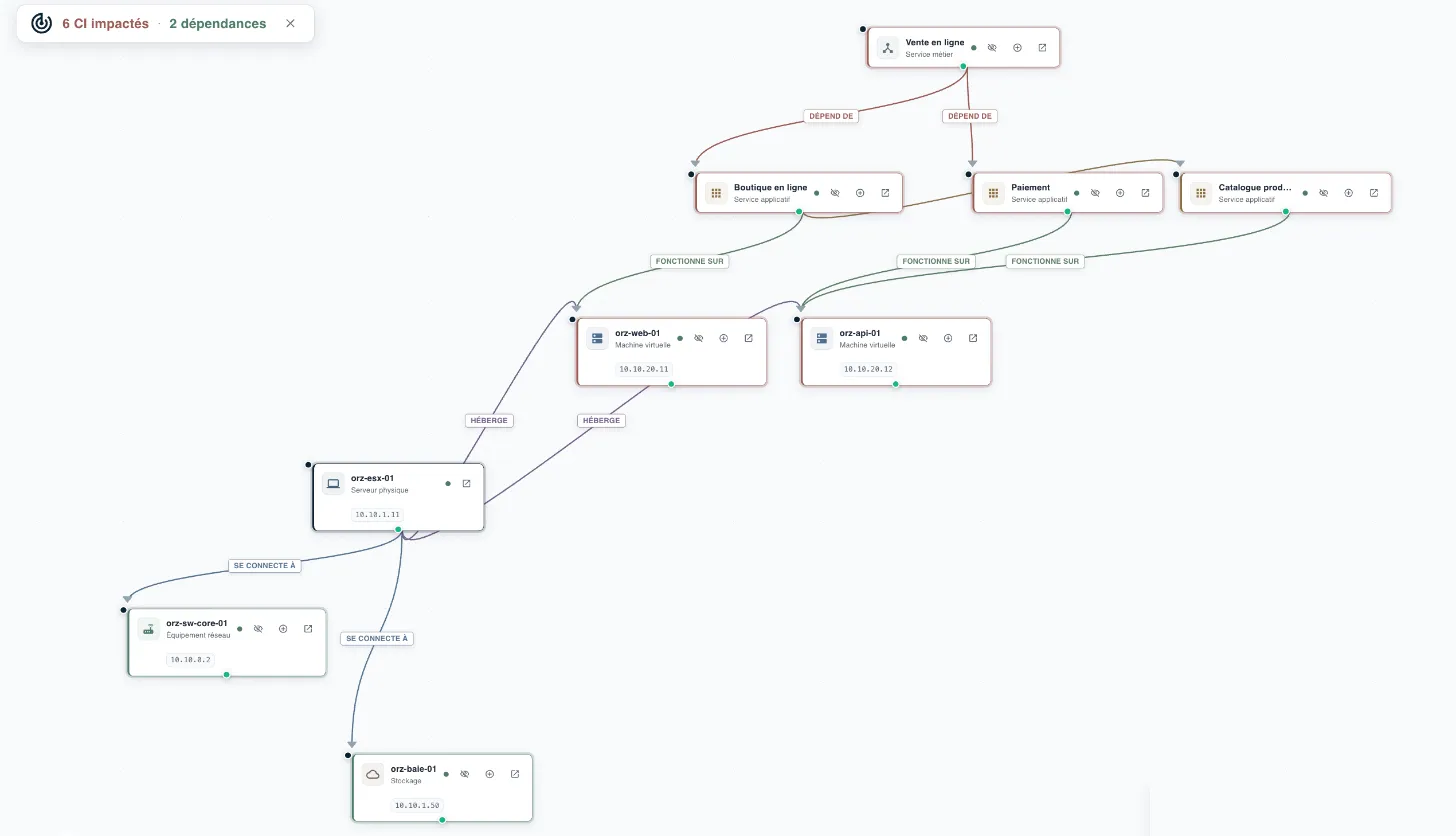
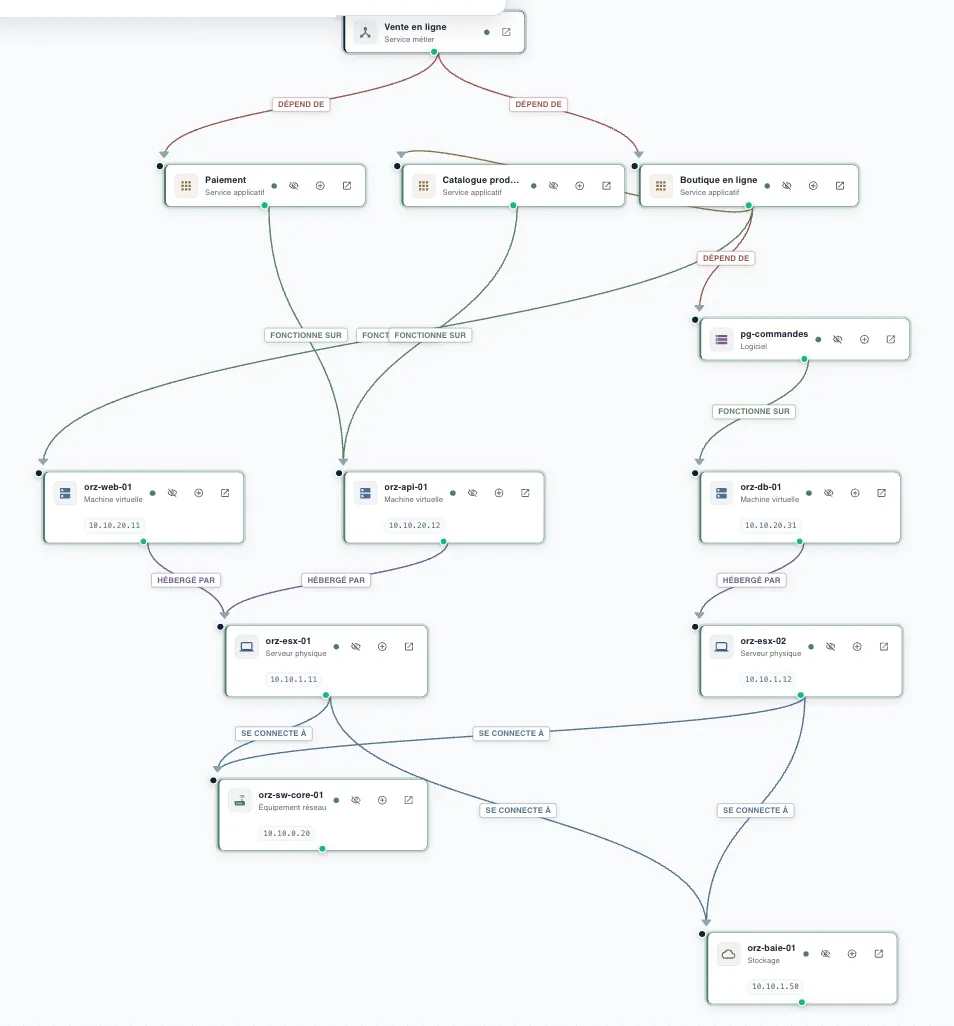
De la découverte (VM hébergée par son hyperviseur, connexions réseau observées, voisins LLDP, charges Kubernetes dans leur cluster), de vos équipes depuis la fiche ou l’explorateur, et de vos référentiels par import. Une relation créée par la découverte n’est jamais supprimée d’office : si elle n’est plus vue, elle devient une proposition de retrait.
Incidents et demandes de changement se rattachent à un CI. Criticité métier, groupe de support et groupe d’attribution portés par le CI guident la priorité et l’escalade.
3 · Faire confiance à la donnée
Chaque source reçoit un niveau de confiance. Une source de confiance écrit directement dans la CMDB ; une source à vérifier propose ses changements, qui attendent une décision. Certains champs peuvent passer par la validation même pour une source de confiance.
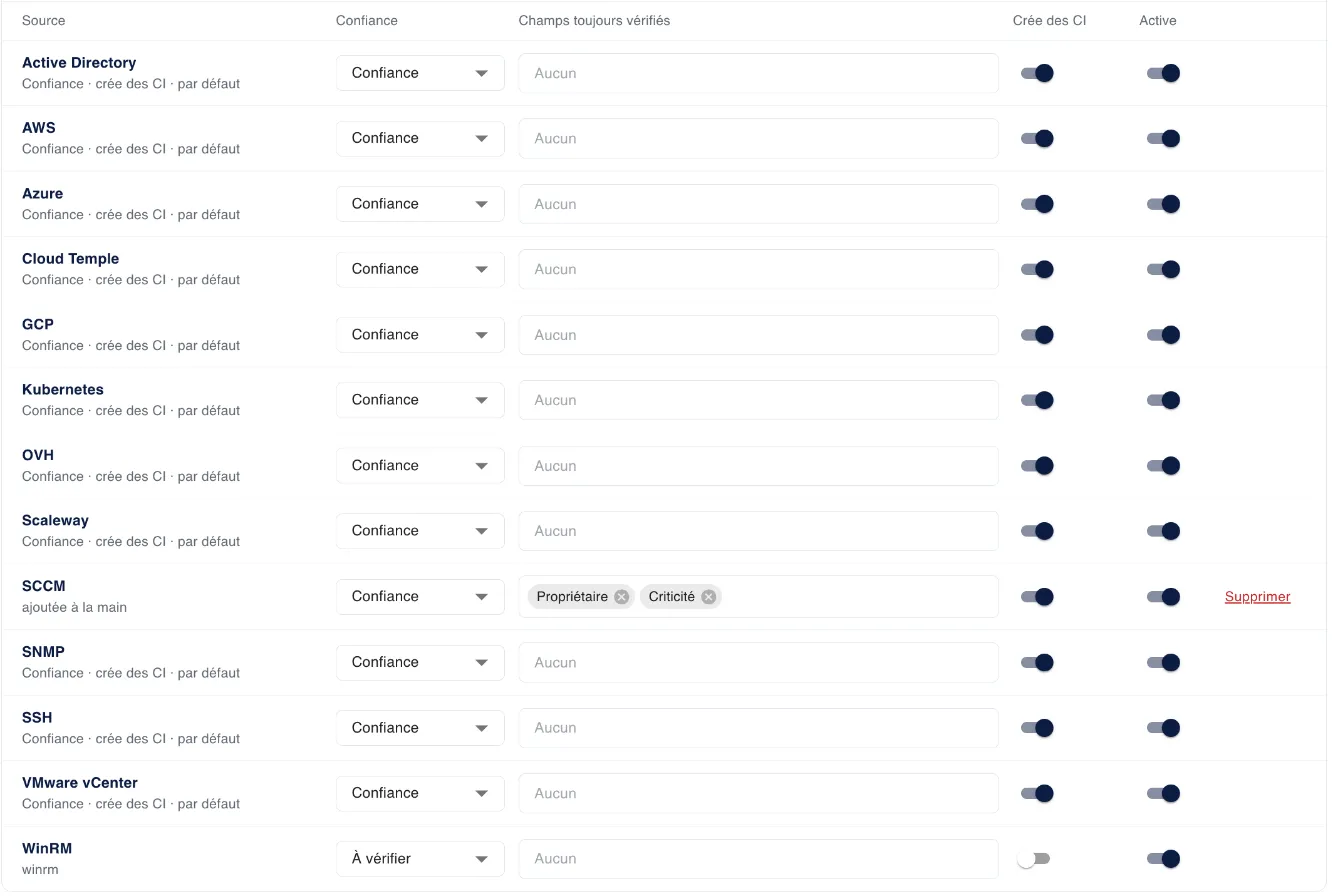
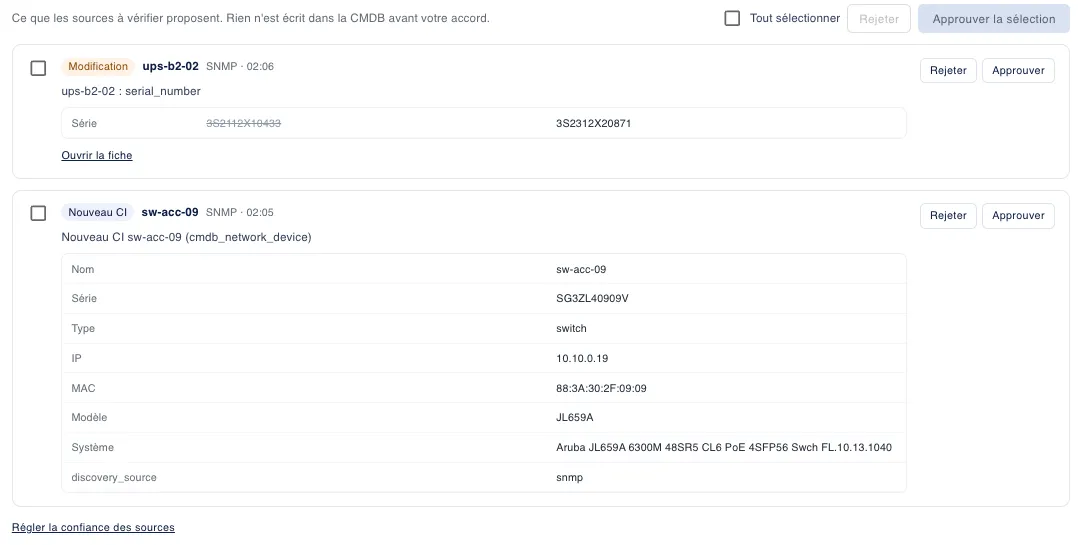
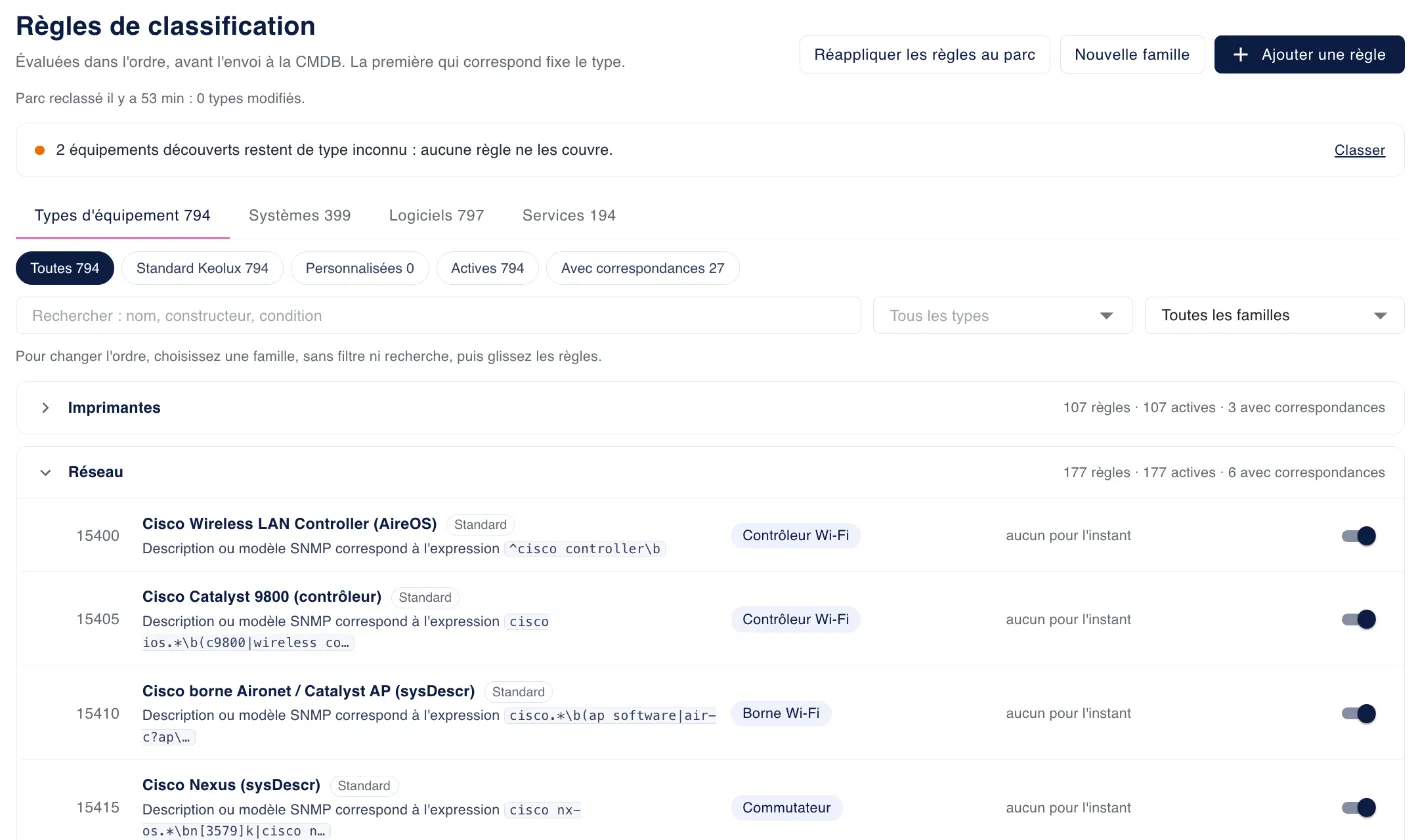
Un équipement est reconnu par son numéro de série, son identifiant matériel ou son adresse MAC avant d’être créé : pas de doublons entre sources.
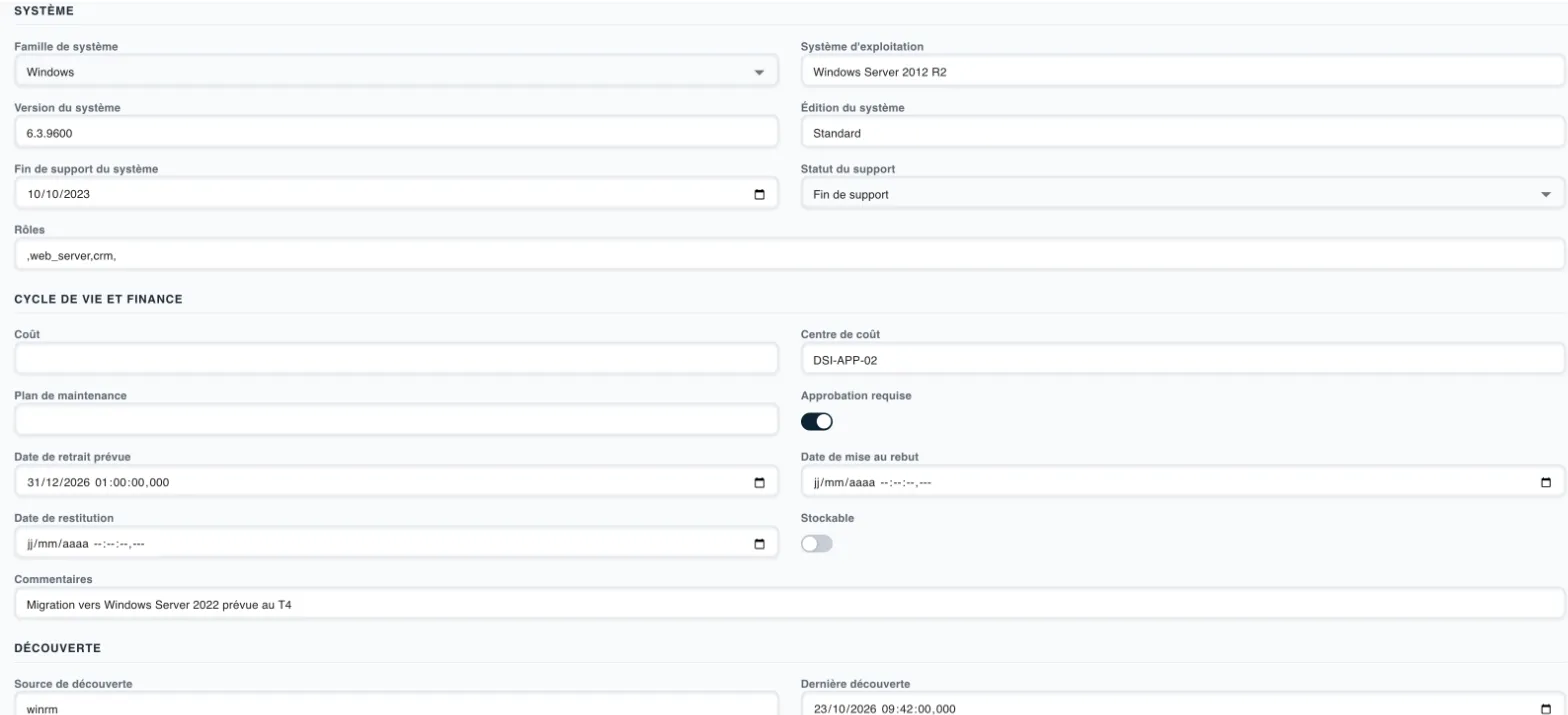
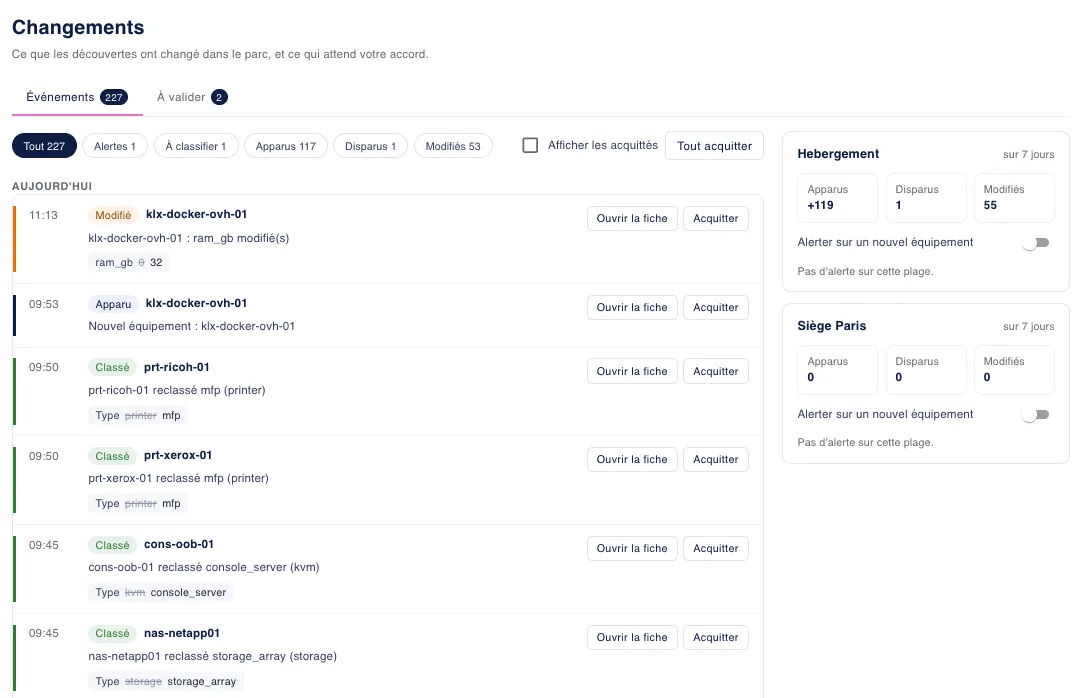
Chaque CI porte sa source et la date de sa dernière découverte. Passé un seuil par type d’équipement, il est signalé disparu et son retrait proposé.
Équipements non classés listés à part, alerte quand un inconnu apparaît sur une plage, rapports sur les CI sans propriétaire ou sans groupe de support.
4 · L’ouvrir au reste du SI
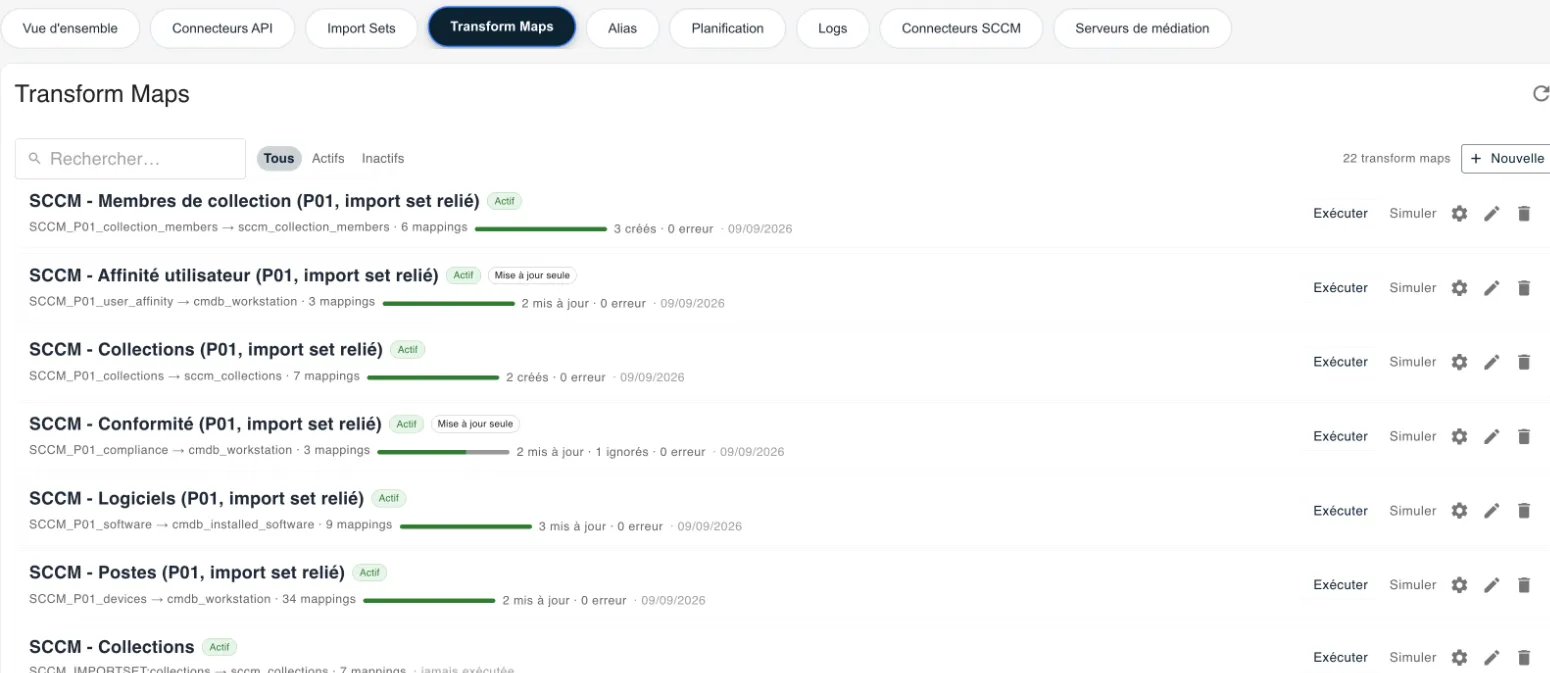
La CMDB peut rester le point de vérité des relations pendant que vos outils spécialisés gardent leur rôle. Pour chaque échange, vous choisissez les tables et les attributs qui entrent et ceux qui sortent.
5 · La gouverner
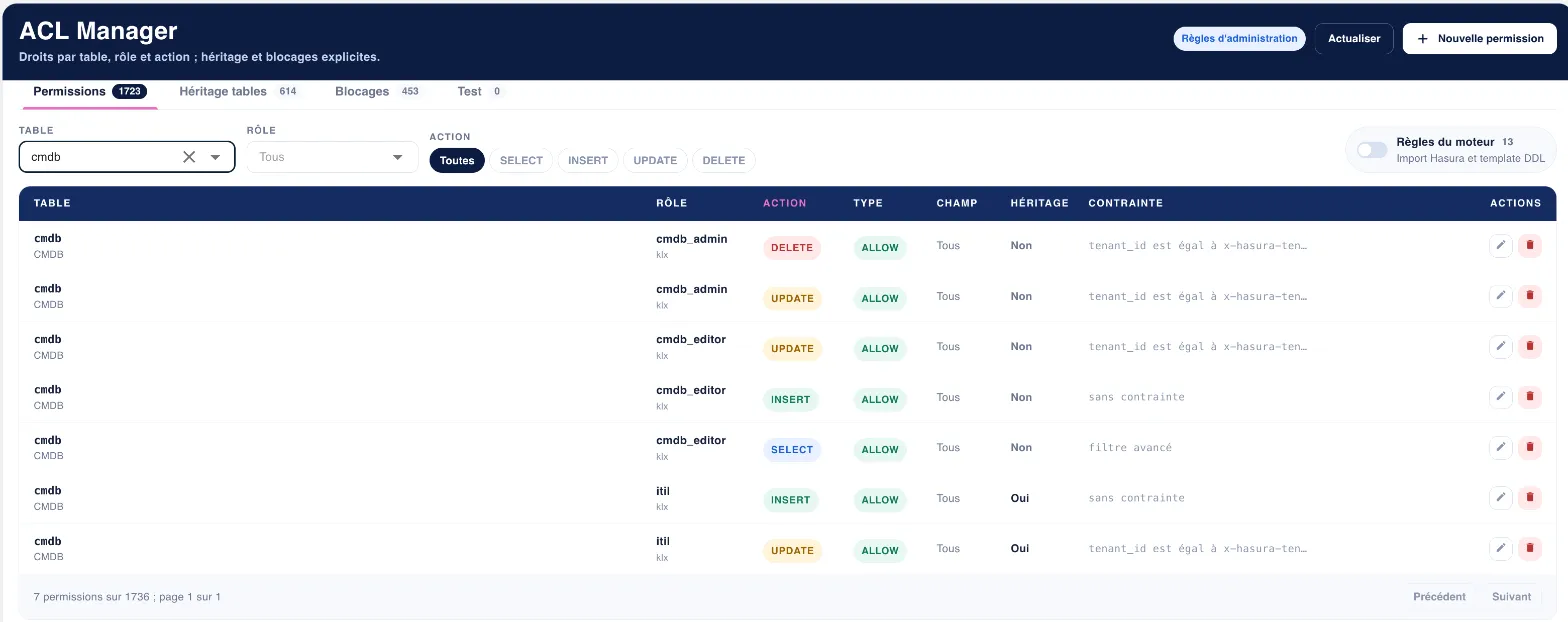
Lecture, édition, administration de la CMDB et de la découverte, validation des propositions, restriction par classe de CI et par attribut sensible.
Chaque création, modification et suppression est journalisée : qui, quand, avec quel rôle, état avant et après. Une saisie manuelle est attribuée à son auteur.
Classes, champs, règles et droits se regroupent dans des paquets de mise à jour qui passent de la recette à la production.
Mise en œuvre
Une CMDB utile ne commence pas par une migration complète. On branche d’abord les sources les plus sûres, on reprend l’historique qui tient la route, et on laisse la découverte faire le reste.
Annuaire, gestion de postes, consoles cloud, hyperviseurs : elles créent et mettent à jour les CI directement.
Seules les données historiques fiables, table par table et champ par champ. Simulation avant exécution, mode mise à jour seule.
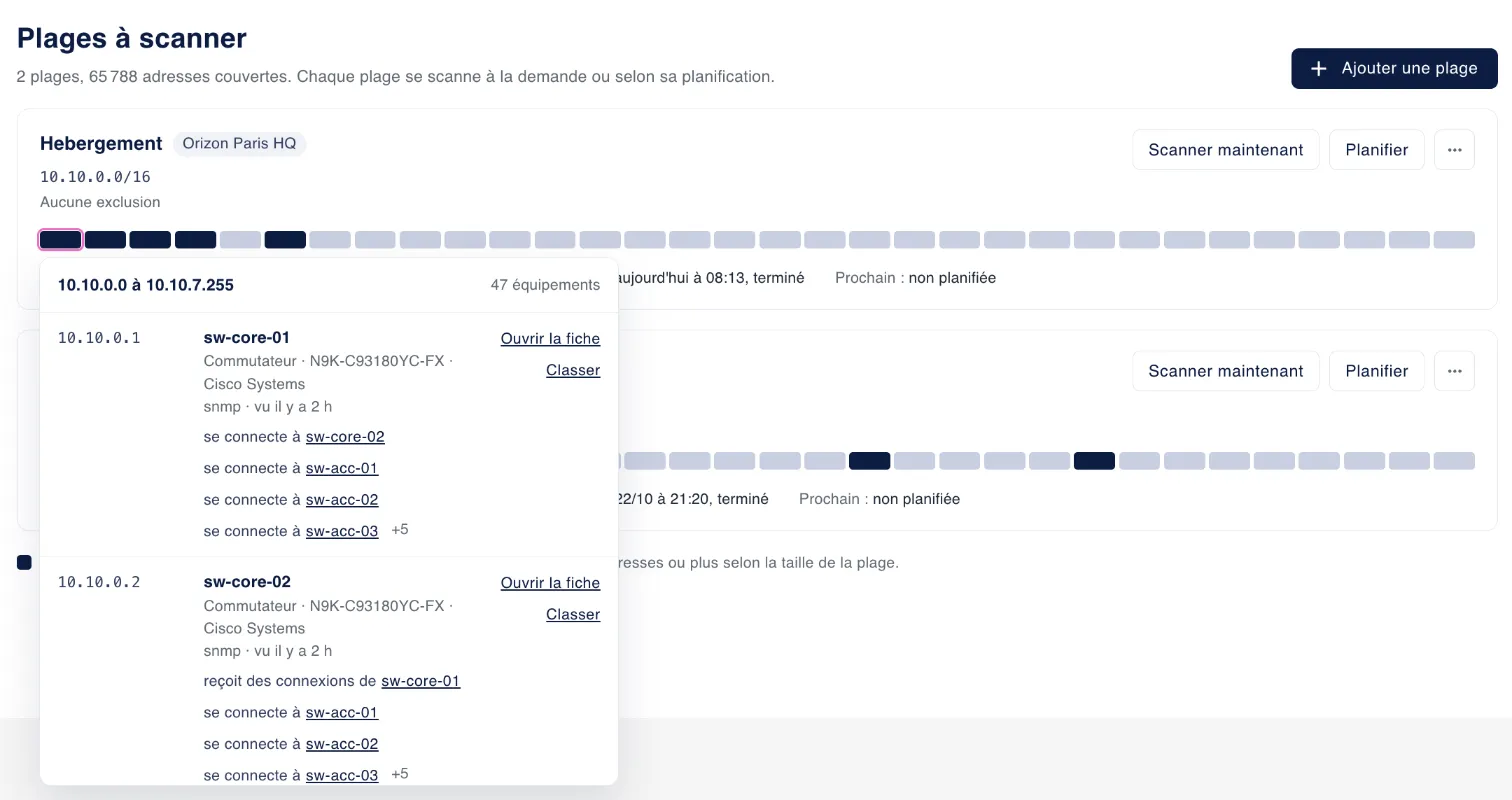
Plages scannées en SNMP, SSH, WinRM et HTTP. Les sources moins sûres passent d’abord par la file de validation.
Services métier et applicatifs décrits avec leurs responsables, reliés à l’infrastructure découverte : l’analyse d’impact devient disponible.
Droits par rôle, vues filtrées enregistrées, portail en libre-service, assistant Kelex pour interroger la découverte en langage courant.
Pour monter en volume, la classification du parc s’exécute côté serveur, par lots, et la collecte se répartit sur plusieurs serveurs KLX-SRV. Pour la définition d’une CMDB, voir aussi le glossaire.
Demander une démoQuestions fréquentes
La Discovery remplit la CMDB et la garde à jour : elle inventorie serveurs, postes, équipements réseau, machines virtuelles, ressources cloud et Kubernetes, crée les relations qu’elle observe (VM hébergée par son hyperviseur, voisins LLDP, connexions réseau) et signale les équipements apparus, disparus ou modifiés.
Non. L’essentiel de la collecte se fait sans agent : SSH, WinRM, SNMP, API des hyperviseurs, du cloud et de Kubernetes. L’agent KEOLUX reste disponible pour les postes Windows, macOS et Linux, et l’inventaire MECM / SCCM peut être repris tel quel.
Non. Le serveur de collecte KLX-SRV s’installe dans votre réseau et va chercher ses travaux auprès de la plateforme en HTTPS sortant. Les identifiants de collecte sont chiffrés dans le navigateur et ne sont conservés que sur le serveur de collecte. Plusieurs serveurs peuvent couvrir plusieurs sites.
Chaque source reçoit un niveau de confiance. Une source de confiance écrit directement ; une source à vérifier propose ses changements dans la file À valider, avec la valeur actuelle et la valeur proposée côte à côte. Certains champs, comme le propriétaire ou la criticité, peuvent passer par la validation même pour une source de confiance.
Avant de créer un CI, la plateforme le rapproche par numéro de série, identifiant matériel ou adresse MAC. Les imports utilisent des clés de rapprochement configurables et peuvent être limités à la mise à jour de CI existants.
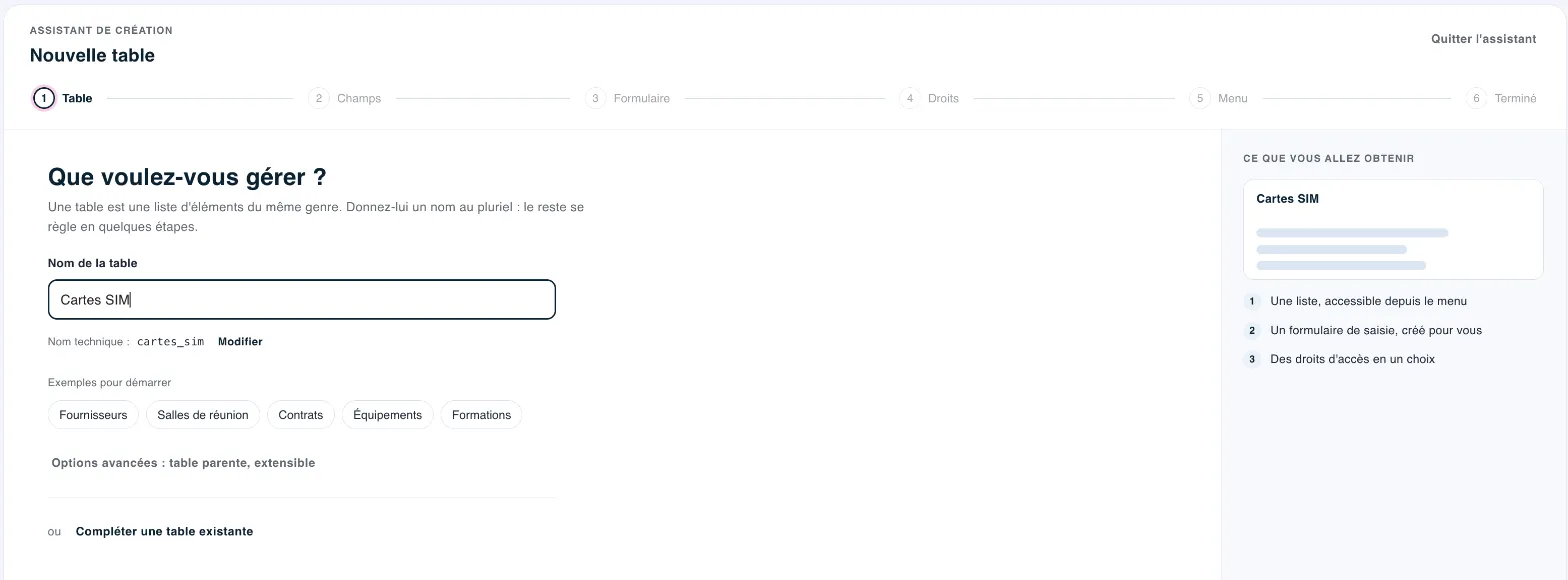
Oui, depuis l’interface d’administration, sans développement : nouvelle classe, nouvel attribut, nouvelle valeur de liste ou nouveau type de relation. La table créée hérite des attributs de sa classe mère et reçoit son formulaire, son menu et ses droits.
Prochaine étape
Réservez 30 minutes avec un expert français : démo personnalisée sur vos processus IT, RH et métiers, chiffrage clair et plan de déploiement adapté à votre contexte.
Demander une démo30 minutes, en visio
Vos outils actuels, vos volumes, ce qui coince aujourd’hui.
La plateforme sur vos cas d’usage, pas une visite générique.
Votre budget selon l’effectif et un plan de déploiement daté.